AIはどうやって「似た文章」を探すのか? ― 数学が苦手でもわかる、言葉の距離とベクトル検索
1章:はじめに
「AIは、言葉の意味を距離で測っている」。そんな説明を見かけたことはないでしょうか。しかしながら、言葉に距離があると言われても、すぐにはイメージしにくいかもしれません。そもそも、形のない言葉をどのように数値で表し、近い、遠いと比べるのでしょうか。
AIを使った文書検索では、単語や文章を複数の数値に変換して扱うことがあります。この数値の並びをベクトルと呼び、単語や文章をベクトルに変換する処理を埋め込みと呼びます。

埋め込みによって作られたベクトルには、単語や文章の意味、使われ方、文脈などの特徴が反映されます。そのため、ベクトル同士を比較することで、2つの文章がどの程度似ているか、あるいは意味的に関連しているかを数値として評価できます。
この仕組みは、質問に関連する資料を探すベクトル検索などに利用されています。例えば、質問文と多数の資料をそれぞれベクトルに変換し、質問文と近い特徴を持つ資料を検索結果として取り出します。
ただし、ChatGPTのような生成AIが文章を作る仕組み全体を、ベクトル同士の距離だけで説明することはできません。生成AIが外部の資料を検索してから回答を作る場合、その資料検索の一部にベクトルによる比較が使われることがあります。
本記事の目的は、AIを使った文書検索で利用される「ベクトル検索」の基本的な仕組みを、難しい数学や数式をできるだけ使わずに理解することです。まず「言葉の近さ」とは何かを身近な例から考え、その後、言葉や文章をベクトルとして表し、その近さをどのように比較するのかを説明します。細かな計算方法を覚える必要はありません。「言葉や文章を数値に変え、その近さを測ることで、質問に関連する資料を探している」という全体像をつかむことを目標にします。
2章:言葉や文章の「近さ」とは何か
距離と聞いて思い浮かぶのは、メートルやキロメートルではないでしょうか。机から窓までは3m、東京から大阪までは約400km。ものさしで測れて、単位があり、誰が測っても同じ値になる。それが私たちのよく知っている距離です。
しかしAIの世界では、日常的に使う距離とは少し異なる意味で、距離の考え方が利用されています。
ここでいう距離は、単語や文章を変換した数値の組同士が、どのくらい近いかを表すものです。単語や文章は埋め込みモデルによってベクトルに変換されます。そして、そのベクトル同士の近さを調べることで、埋め込みモデルが作った表現の中で、それらがどの程度似た特徴を持つかを評価できます。これが、この章でお伝えしたい中心的な考え方です。
もう少し具体的に見ていきましょう。単語や文章をベクトルに変換した後、そのベクトル同士の距離や類似度を計算します。距離はベクトル同士の離れ具合を数値化したもので、一般に値が小さいほど近いことを表します。一方、類似度は似ている度合いを数値化したもので、一般に値が大きいほど近いことを表します。どちらも、単語や文章がどの程度近い特徴を持つかを表すために使われます。例えば、あくまでイメージとしては、
「犬」と「猫」→ どちらも身近な動物で、意味が似ている → 近い
「バナナ」と「黄色」→ 同じ意味ではないが、意味的な関連が強い → 近い
「犬」と「サボテン」→ 意味や使われる場面の関連が比較的弱い → 遠い
つまり、「似ている・関連しているものを近い」「関連の弱いものを遠い」と表現しているわけです。メートルのような単位はありませんが、「近い」「遠い」という感覚だけ、日常の距離から借りています。

マジカルバナナが得意な人は、もう感覚を掴んでいる
似ている度合いを距離で表す、と言われてもピンとこないかもしれません。しかし、この感覚は連想ゲームで遊んだ経験のある方なら、意外と身近なものです。
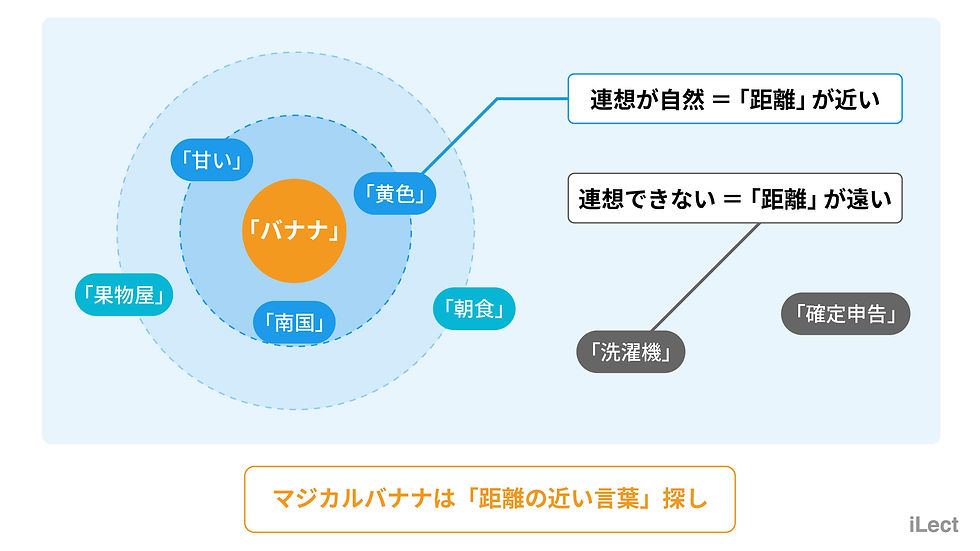
連想ゲームの「マジカルバナナ」を思い出してください。「バナナと言ったら黄色」「黄色と言ったら信号」と、関連する言葉をリズムに乗ってつないでいくゲームです。
このとき、頭の中で起きていることをあえて「距離」という言葉で表すなら、
「バナナ」から比較的近い言葉=距離が近い言葉(黄色、甘い、南国……)を探して答えている
「バナナと言ったら洗濯機」のように関連の弱い言葉=距離が遠い言葉、を答えるとうまく連想が繋がらない
と考えることができます。つまり、マジカルバナナは、意味的に関連する言葉をすばやく見つけるゲームだと考えられます。
もちろん、人間の連想とAIの埋め込みがまったく同じ仕組みというわけではありません。ただ、ベクトル検索では、この「関連するものほど近く感じる」という直感に似た関係を、コンピュータで扱える数値として表現しています。
言葉を意味の地図に並べる
では、言葉や文章をどのように数値として表すのでしょうか。イメージしやすくするために、埋め込みモデルが作るベクトルの世界を「巨大な意味の地図」と考えてみましょう。
埋め込みモデルは、大量のテキストから言葉や文章の使われ方に関する特徴を学習し、入力された単語や文章をベクトルへ変換します。その結果、意味や使われ方が似ているもの、あるいは関連性の高いものが、ベクトルの空間でも比較的近く表現されるようになります。人間が「犬はここ」「猫はここ」と一つずつ位置を決めているわけではありません。学習されたモデルが、入力された言葉や文章に応じて数値の組を出力します。
この数値の組が、ここまで登場してきたベクトルです。ベクトルは「意味の地図上の住所」のようなものだ、とイメージしておけば十分です。次の章では、その住所同士がどのくらい近いのかを調べる代表的な方法を見ていきます。
3章:ベクトルの近さを調べる3つの方法
ベクトル同士の近さを評価する方法には、いくつかの種類があります。ここでは、ベクトル検索で代表的な方法である、ユークリッド距離、コサイン類似度、内積の3つを紹介します。この3つは、すべて同じ種類の指標というわけではありません。
ユークリッド距離:2つのベクトルがどれだけ離れているかを測る。値が小さいほど近い。
コサイン類似度:2つのベクトルの向きがどれだけ似ているかを測る。値が大きいほど似ている。
内積:2つのベクトルの向きと大きさの両方が影響する値。モデルによっては検索の類似度スコアとして利用される。
まずは、「ユークリッド距離は小さいほど近い。一方、コサイン類似度や内積を検索スコアとして使う場合は、大きいほど上位になりやすい」という違いを押さえておけば十分です。
方法①:ベクトル間の直線距離を測るユークリッド距離
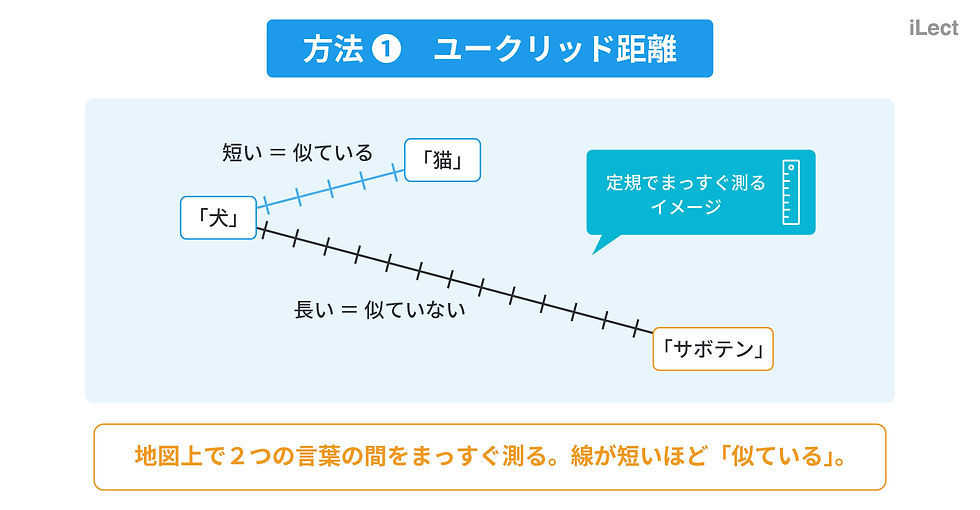
ユークリッド距離は、2つのベクトルがどれだけ離れているかを表す方法です。2次元の図では、2つの点を結ぶ直線の長さとして表せます。距離の値が小さいほど2つのベクトルは近く、値が大きいほど離れていると判断します。
単語や文章を同じ埋め込みモデルでベクトルに変換した場合、モデルが似た特徴を持つものとして表現した文章同士は、ユークリッド距離も小さくなることがあります。
図では2次元の点として表しますが、実際の埋め込みベクトルは、数百個、数千個といった多くの数値から構成されることがあります。ユークリッド距離は、そのような高次元のベクトルに対しても計算できます。
方法②:ベクトルの向きを比べるコサイン類似度
コサイン類似度は、2つのベクトルがどの程度同じ方向を向いているかを表す方法です。ベクトルを原点から伸びる矢印として考えると、2本の矢印の角度が小さいほどコサイン類似度は高くなります。反対に、向きが大きく異なるほど値は低くなります。
コサイン類似度では、ベクトルの長さの影響を取り除き、主に方向の近さを比較します。そのため、埋め込みベクトル同士の類似性を評価する方法として広く利用されています。数学上、コサイン類似度は−1から1までの値を取ります。
1に近い:2つのベクトルの向きが近い
0に近い:2つのベクトルがほぼ直角
−1に近い:2つのベクトルがほぼ逆向き
ただし、−1だから意味が反対である、0だから完全に無関係である、と直接解釈できるわけではありません。どのような値が現れるかは、使用する埋め込みモデルによって異なります。

方法③:ベクトルの向きと大きさが影響する内積
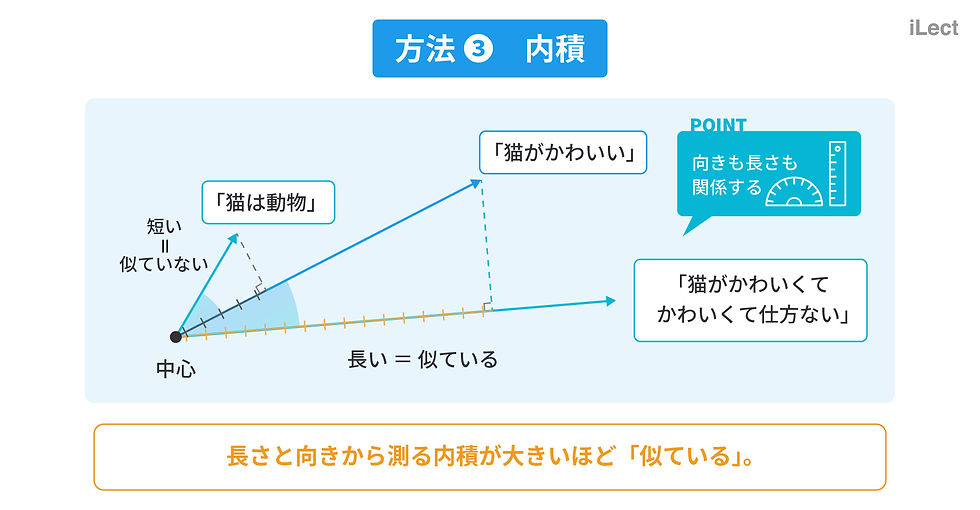
内積も、2つのベクトルを比較して一つの数値を求める方法です。コサイン類似度との違いは、ベクトルの向きだけでなく、ベクトルの大きさも結果に影響することです。2つのベクトルが同じような方向を向いている場合でも、ベクトルの長さが異なれば、内積の値は変化します。
ただし、ベクトルの大きさが何を表すかは、埋め込みモデルによって異なります。そのため、「ベクトルが大きいほど文章の特徴が強い」などと単純に解釈することはできません。
内積を使うことを前提として学習された埋め込みモデルでは、ベクトルの大きさも含めた内積の値が、検索順位を決めるスコアとして利用されます。その場合は、内積が大きい候補ほど、質問との関連性が高いものとして扱われます。
正規化すると、3つの方法の関係が見えてくる
ベクトルの長さを1にそろえる操作を、正規化と呼びます。2つのベクトルを正規化してから内積を計算すると、その値はコサイン類似度と一致します。つまり、正規化されたベクトルでは、内積とコサイン類似度は同じ値になります。
さらに、すべてのベクトルの長さが1にそろっている場合、ユークリッド距離もコサイン類似度と一定の関係を持ちます。コサイン類似度が高いほどユークリッド距離は小さくなるため、検索候補を近い順に並べた場合、その順位も一致します。
つまり、ベクトルが正規化されていれば、
コサイン類似度
内積
ユークリッド距離
のどれを使っても、同じ候補が同じ順番に並びます。
もちろん、求められる数値そのものはユークリッド距離とコサイン類似度では異なります。同じになるのは、「どれが近いか」という順位です。
ここは少し発展的な内容なので、「ベクトルの長さを1にそろえると、3つの比較方法は同じ順位を与える」と理解しておけば十分です。
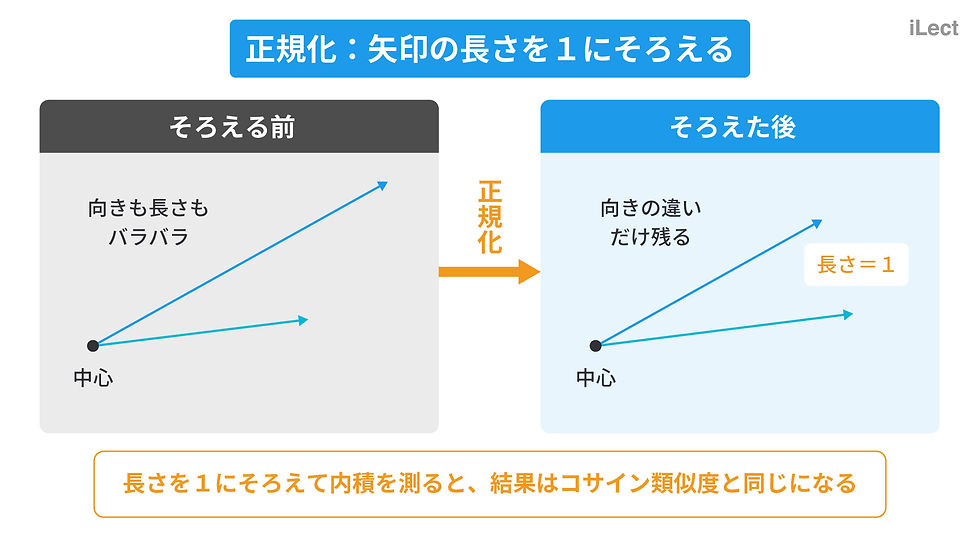
①も含めた3つは、それぞれ無関係ではありません。ベクトルの長さを1にそろえた場合、コサイン類似度、内積、ユークリッド距離は互いに密接な関係を持ち、候補の並び順が同じになることがあります。難しい計算まで覚える必要はありません。3つは別々の道具ではなく、同じベクトルを、異なる計算方法で比較しているのだ、と知っておけば十分です。
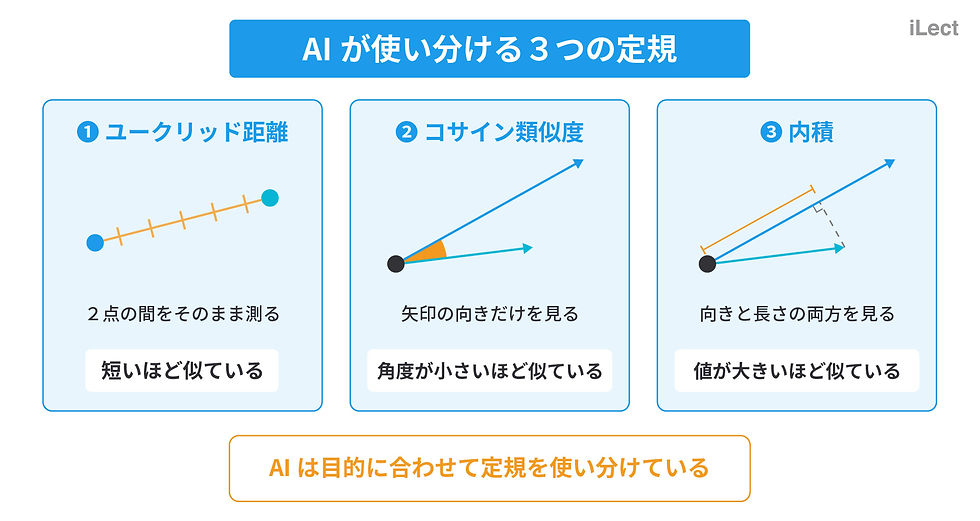
このように、3つの方法は完全に独立しているわけではありません。とくに、ベクトルを正規化しているかどうかによって、それぞれの違いは大きく変わります。
どの方法を使うべきかは、埋め込みモデルの学習方法や検索システムの設計によって決まります。実際にベクトル検索を行う場合は、使用する埋め込みモデルが推奨している比較方法を選ぶことが基本です。
4章:どの比較方法を選べばよいのか
ユークリッド距離、コサイン類似度、内積の違いがわかっても、実際にどの方法を使えばよいのか迷うかもしれません。基本的には、利用者が感覚だけで自由に選ぶのではなく、使用する埋め込みモデルが推奨している方法に従うことが重要です。
埋め込みモデルによって推奨される方法が異なる
埋め込みモデルは、それぞれ異なる方法で学習されています。コサイン類似度による比較を前提としているモデルもあれば、内積による比較を前提としているモデルもあります。そのため、実際にベクトル検索を行う場合は、まず使用する埋め込みモデルが推奨している比較方法を確認することが重要です。
モデルの想定と異なる比較方法を使うと、質問との関連性が高い文書を適切に順位付けできない場合があります。
また、3章で説明したように、ベクトルが長さ1に正規化されている場合には、コサイン類似度と内積は同じ値になり、ユークリッド距離でも同じ順位になります。そのため、「どの比較方法を使うか?」だけでなく、「ベクトルが正規化されているか?」も重要です。

検索精度は比較方法だけでは決まらない
検索結果が期待どおりにならない場合、比較方法だけが原因とは限りません。
検索精度には、
使用する埋め込みモデル
検索対象となる文書の内容
文書をどのくらいの長さに区切るか
質問文の書き方
何件の候補を取り出すか
など、さまざまな要因が影響します。そのため、比較方法を変更するだけで検索結果が必ず改善するとは限りません。まずは埋め込みモデルの推奨設定を使い、そのうえで文書の分割方法や検索条件を調整するのが基本です。
ベクトルによる比較は身近なサービスでも使われている
ベクトルによる比較は、文書検索だけでなく、さまざまなサービスの一部で利用されています。
たとえば検索システムでは、「安いホテル」という質問に対して、「格安の宿」のように表現が異なる文書を見つけるために使われることがあります。また推薦システムでは、商品、動画、利用者の特徴などをベクトルとして表し、近い特徴を持つ候補を探す場合があります。生成AIが外部の資料を参照して回答を作る仕組みでも、質問に関連する資料を探すためにベクトル検索が利用されることがあります。
ただし、これらのサービスがベクトルの比較だけで動いているわけではありません。実際のシステムでは、キーワード検索、利用履歴、人気度、フィルタリング、検索結果の並べ替えなど、複数の仕組みが組み合わされています。ベクトルによる距離や類似度の計算は、こうした複雑なシステムを支える要素の一つです。
5章:まとめ ― ベクトル検索の基本を振り返る
最後に、1章で挙げた問いに戻ってみましょう。「言葉に距離なんてあるのか」「そもそもベクトルとは何なのか」という問いです。
言葉そのものに、メートルやキロメートルで測れる物理的な距離があるわけではありません。AIを使った文書検索では、単語や文章をベクトルという数値の組に変換し、そのベクトル同士の距離や類似度を計算することで、質問に関連する資料を探しています。
この記事で説明した内容をまとめると、次のようになります。
言葉の距離とは?:言葉や文章の関連性・類似性を表現する考え方
埋め込みとは?:単語や文章を数値の羅列(ベクトル)に変換する処理 ⇒数値となればコンピュータが計算できる
ベクトルの近さを評価する代表的手法:ユークリッド距離・コサイン類似度・内積
どの手法を使用すべき?:使用する埋め込みモデルが推奨する比較方法を選ぶことが基本
よくある勘違い1:
✕ 2つ文章(ベクトル)が近い=絶対に2つの文章が全く同じ意味となる
〇 2つ文章(ベクトル)が近い=2つの文章は関連性が高い(同じ話題に属している・似た文脈で使われる など)
よくある勘違い2:
✕ 文章(ベクトル)の類似度が高い=その内容の正誤の保証となる
〇 文章(ベクトル)の類似度による評価は、あくまで関連する文章の候補を探す手法である
ベクトル検索の重要なポイントは、「言葉そのものの距離」を測っているのではなく、言葉や文章を数値として表現したうえで、その数値同士の近さを比較しているということです。この仕組みによって、使われている単語が完全には一致していなくても、意味的に関連する文章を検索できるようになります。
生成AIが外部資料を参照して回答を作る仕組みでも、このベクトル検索が資料を探す手段の一つとして使われることがあります。ただし、生成AIが文章を生成する仕組みそのものとは区別して考える必要があります。
この記事が、AIを使った文書検索の仕組みを理解する第一歩になれば幸いです。
iLectでは、データサイエンスはもちろん、AIリテラシーからE資格取得のための講座まで幅広くご提供しております。社員のスキル目標の設定や不足している人材の洗い出しなど、ヒアリングを通して最適なセミナーをご提案させていただきます。人材育成にお悩みの方は、ぜひお気軽にお問い合わせください。


